01 / 数据构成
规模、关键指标与数据流
用毫秒级注视轨迹还原阅读的认知过程
- 420 h
- 总时长
- 960 名
- 被试
- 1,280 篇
- 文本
- 1,000 Hz
- 采样率
| 数据流 | 规格 | 说明 |
|---|---|---|
| 眼动 | 1,000 Hz · 双眼 | 屏幕式遥测眼动仪,含瞳孔直径 |
| 音频 | 48 kHz / 24-bit | 朗读模式的同步语音 |
| 文本 | UTF-8 / JSON | 词边界、句法树与兴趣区定义 |
表格为示例批次的采集参数,最终规格以随数据交付的说明文档为准。
02 / 数据说明
采集、标注与质量控制
以下内容说明数据如何被采集、标注与验证,可作为方法学引用与方案评估的依据。
数据概况
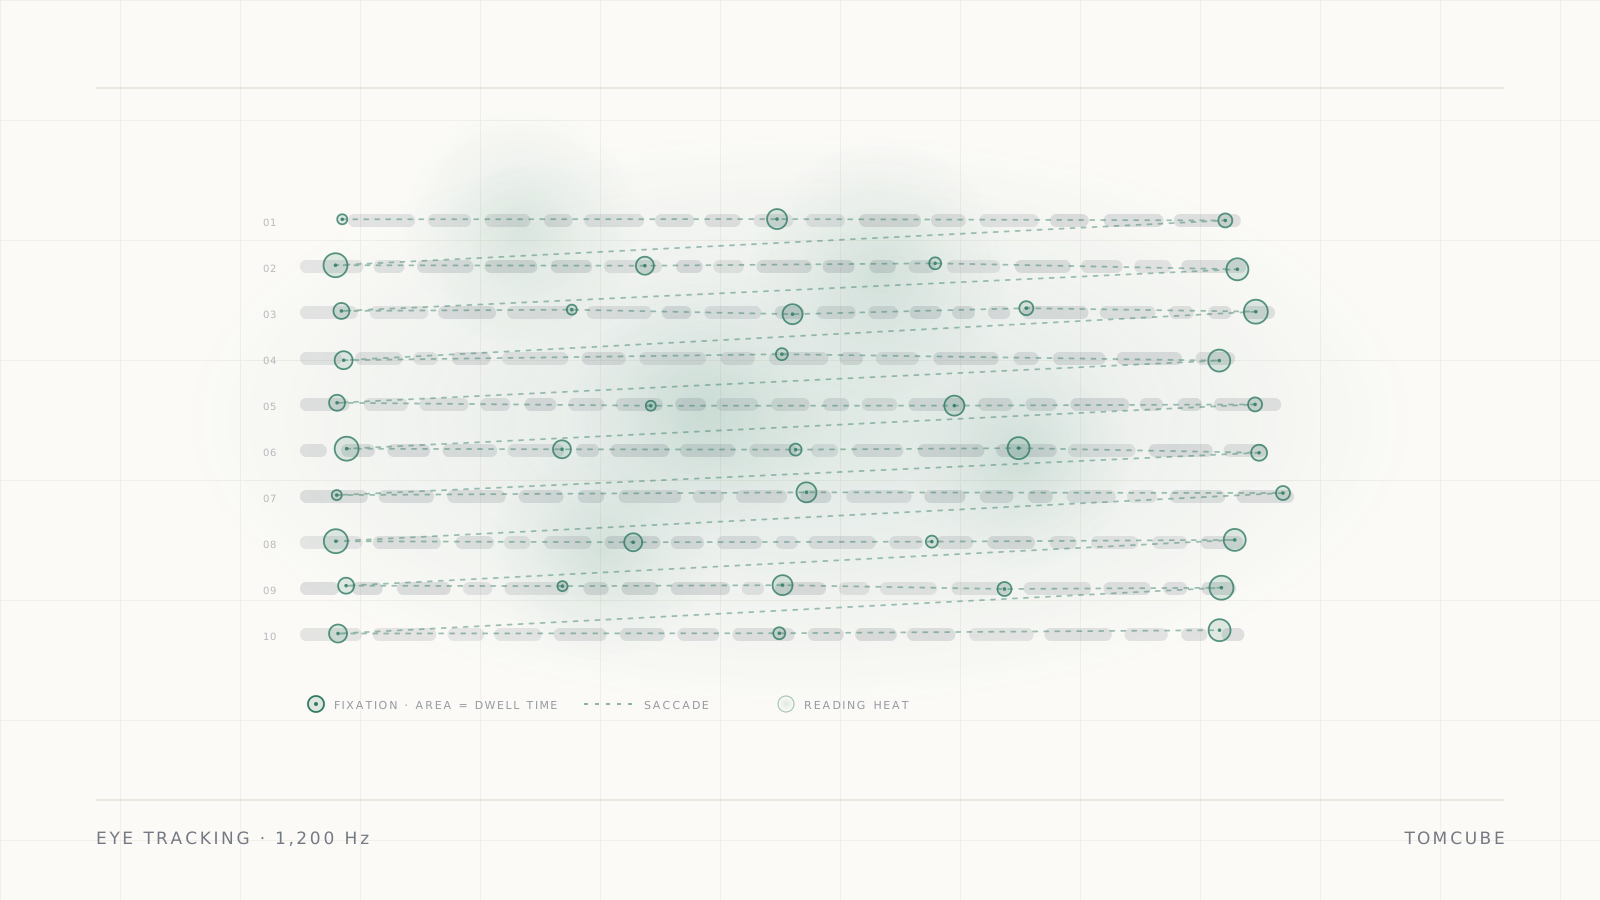
眼动阅读与认知语料库包含 960 名被试阅读 1,280 篇中文文本的眼动记录,累计 420 小时,采集时间为 2024 年 5 月至 2026 年 3 月。文本覆盖说明文、议论文、记叙文与新闻 4 类文体,平均篇幅 620 字,生词密度与句法复杂度经过分级控制。
被试按阅读能力(熟练读者、一般读者、二语学习者)、年龄与教育背景分层。实验包含默读与朗读两种条件,朗读条件同时记录语音,用于研究眼音距(eye-voice span)与阅读流畅性。
采集规范
实验在光线受控的行为实验室进行,屏幕式遥测眼动仪采样率 1,000 Hz,记录双眼注视与瞳孔直径。被试头部以颌托固定,眼睛距屏幕 65 cm,五点校准误差超过 0.5° 视视角即重新校准。每篇文本前呈现注视点,阅读结束后完成理解判断题,正确率低于 70% 的试次标记为无效。
朗读条件使用头戴式麦克风,48 kHz / 24-bit 录制。眼动与音频通过同一触发盒同步,刺激呈现软件在每次翻页时写入事件标记。所有被试签署知情同意书,视力或矫正视力正常,无阅读障碍诊断史。
标注体系
文本侧与眼动侧标注分开组织,再通过试次 ID 关联。
| 层级 | 内容 | 规模 | 复核方式 |
|---|---|---|---|
| 文本层 | 分词、词性、句法树、词频与具体度 | 1,280 篇 | 人工校对 20% |
| 兴趣区层 | 词、短语、句子三级 AOI | 约 78 万个 AOI | 自动生成 + 抽检 |
| 眼动层 | 注视、眼跳、回视、瞳孔直径 | 全量事件流 | 算法检测 + 人工复核 10% |
| 语音层 | 朗读音素边界与眼音距 | 约 260 小时 | 强制对齐 + 抽检 |
质量与验证
眼动与语音同步误差中位数 1.8 ms,95 分位不超过 3 ms;校准平均误差 0.28°;注视事件检测与人工复核一致率 96.4%;文本分词与句法标注一致性 κ = 0.92。每批次抽取 10% 被试做全流程复核,剔除眨眼、丢失追踪比例超过 15% 的试次。交付附实验程序说明、AOI 定义文件、指标计算脚本与质量报告。
典型研究问题
- 中文词频与首次注视时间、总注视时间的关系。
- 句法歧义消解中的回视模式与再分析成本。
- 朗读时眼音距随文本难度的变化。
- 二语学习者与母语者阅读策略的眼动差异。
- 瞳孔直径能否反映阅读中的认知负荷。
获取与授权
科研授权面向心理语言学、认知科学与教育研究团队,商业授权面向阅读产品、教育测评与无障碍技术团队。交付格式为 CSV、TSV、WAV 与 JSON,附指标字典与分析脚本示例。可按文体、阅读条件与被试群体筛选子集。可先通过示例数据查看试次级数据结构,或在联系页说明研究设计获取报价。
03 / 典型用途
这批数据可以回答的问题
以下为典型研究与产品方向,具体分析方案需结合研究设计与统计方法确定。
- 01
中文阅读的眼动控制模型
- 02
词频与注视时间关系
- 03
二语读者阅读策略对比
- 04
阅读困难筛查指标
04 / 相关数据集
可以组合使用的数据集
同一研究问题常需要跨模态组合;以下条目与本数据集共享场景、说话人或标注体系。