01 / 数据构成
规模、关键指标与数据流
沿着成长时间轴记录语言的出现与变化
- 540 h
- 总时长
- 260 名
- 儿童
- 36 个月
- 追踪周期
- 214 户
- 家庭
| 数据流 | 规格 | 说明 |
|---|---|---|
| 音频 | 48 kHz / 24-bit | 领夹麦克风,儿童与照护者分轨 |
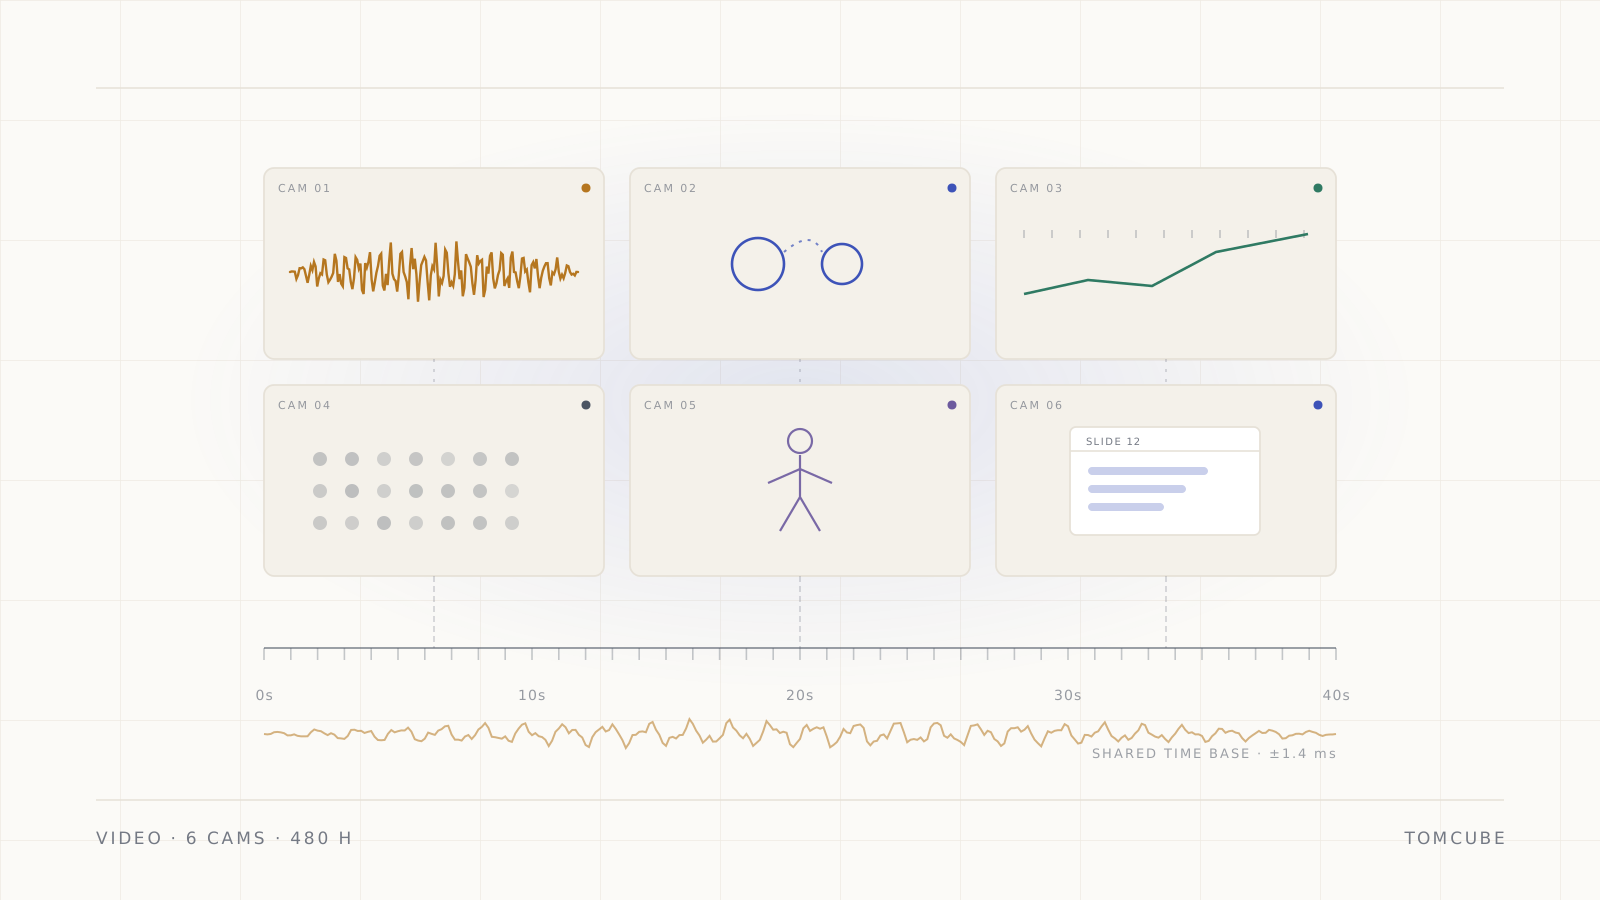
| 视频 | 1920 × 1080 · 30 fps | 家庭自然场景单机位 |
| 文本 | CHAT / UTF-8 | CHAT 转写与词性、句法层标注 |
表格为示例批次的采集参数,最终规格以随数据交付的说明文档为准。
02 / 数据说明
采集、标注与质量控制
以下内容说明数据如何被采集、标注与验证,可作为方法学引用与方案评估的依据。
数据概况
儿童语言发展追踪语料库对 260 名儿童进行为期 36 个月的纵向追踪,来自 214 户家庭,累计 540 小时自然互动语料,采集时间为 2023 年 2 月至 2026 年 2 月。儿童入组年龄为 18 至 42 个月,每 3 个月完成一次家庭录制,每次约 45 分钟,内容包括自由游戏、绘本共读与用餐对话三类活动。
语料按年龄、性别、家庭语言环境(单语 / 双语)与照护者教育背景分层。追踪期内退出 12 名儿童,退出原因与时间均记录在元数据中,便于分析样本流失偏差。
采集规范
采集以家庭自然场景为主,避免实验室环境对儿童表达的影响。儿童与照护者各佩戴一枚领夹麦克风,48 kHz / 24-bit 分轨录制;视频使用单机位 1920 × 1080 · 30 fps,拍摄游戏区与阅读区,不移动机位以避免干扰。
研究助理在录制前完成设备摆放与音校准,录制后退场,由家长操作简单的开始与结束流程。所有家庭签署知情同意书,儿童在录制中表现出不适时立即终止。涉及家庭成员身份的片段在入库前完成遮挡与变声处理。
标注体系
转写遵循 CHAT 规范,并在其上叠加语音与互动层标注。
| 层级 | 内容 | 规模 | 复核方式 |
|---|---|---|---|
| 转写层 | CHAT 逐句转写、发音变体、重复与自我修正 | 约 60 万句 | 双盲复核 25% |
| 语音层 | 音段偏误、音节结构、声调实现 | 约 18 万个偏误实例 | 语音学标注员双人复核 |
| 语法层 | 词性、句长、从句深度 | 全量 | 自动标注 + 人工校对 20% |
| 互动层 | 共同注意、轮流、扩展与重述 | 10 类行为 | 关键片段双人标注 |
质量与验证
音视频同步误差中位数 1.5 ms,95 分位不超过 2 ms;CHAT 转写一致性 κ = 0.90;语音偏误标注一致性 κ = 0.84;亲子互动编码一致性 κ = 0.86。每批次抽取 15% 样本做双盲复核,其中 5% 由发展语言学研究者终审。交付附年龄常模表、转写规范、标注手册与纵向匹配说明。
典型研究问题
- 汉语儿童声调与辅音习得的先后顺序。
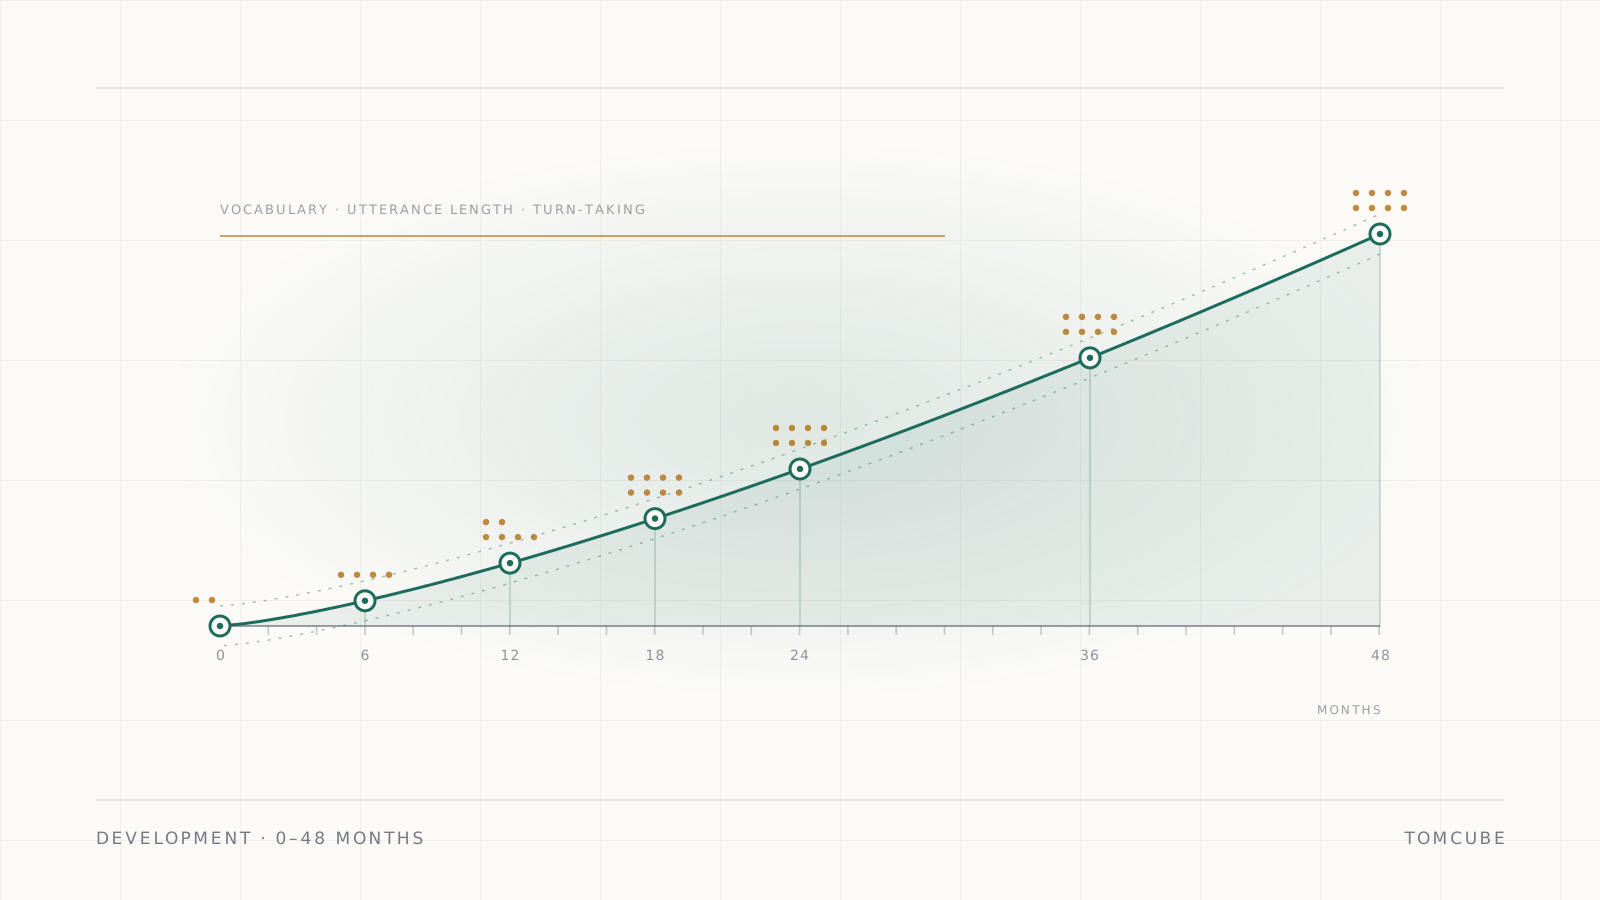
- 词汇量与句法复杂度的纵向增长曲线。
- 亲子共读中的扩展与重述对语言发展的影响。
- 语言发展迟缓的早期语音与互动特征。
- 双语环境对儿童语码转换模式的影响。
获取与授权
本数据集仅面向通过伦理审查的科研项目开放,申请方须提交研究方案、伦理批件与儿童数据保护措施。交付格式为 WAV、MP4、CHAT 与 JSON,可按年龄段与活动类型筛选,纵向匹配 ID 已做不可逆映射。商业使用需单独评估,原则上不提供原始影像。可先通过示例数据了解 CHAT 字段结构,或在联系页咨询申请流程。
03 / 典型用途
这批数据可以回答的问题
以下为典型研究与产品方向,具体分析方案需结合研究设计与统计方法确定。
- 01
儿童语音习得顺序研究
- 02
词汇增长与句法复杂度分析
- 03
语言发展迟缓早期特征
- 04
亲子互动质量评估
04 / 相关数据集
可以组合使用的数据集
同一研究问题常需要跨模态组合;以下条目与本数据集共享场景、说话人或标注体系。