Multimodal language science · data infrastructure
为前沿科学,构建
可验证的多模态数据
面向高校与企事业单位,提供多模态数据的研究设计、采集、处理与验证。语音、视频、文本、眼动与生理信号共用一条时间轴,交付可复现、可审计、可引用的研究级数据。
- ISO 27001 信息安全
- IRB 伦理协作流程
- 10+ 家机构在用
00:12.480嗯,我们先把这张图放到小组的桌子上,然后——
aligned1.4 ms
跨流同步
κ 0.91
标注一致
98.7%
批次通过
- 12,400小时
- 已验证多模态语料
- 38种
- 语言与方言
- 10+家
- 高校与机构
- 0.91κ
- 标注一致性中位数
通过同步与质检并完成交付的净时长
覆盖汉语七大方言区与 12 个少数民族语言
语言学、心理学、教育学与人工智能实验室
双盲标注复核,2025 年度交付批次
01 / Data modalities
六类模态,一条时间轴
单模态数据回答不了多模态问题。我们把语音、视频、文本、眼动、生理与动作数据统一到同一时基,并以同一套验证标准交付。
语音9 个数据集
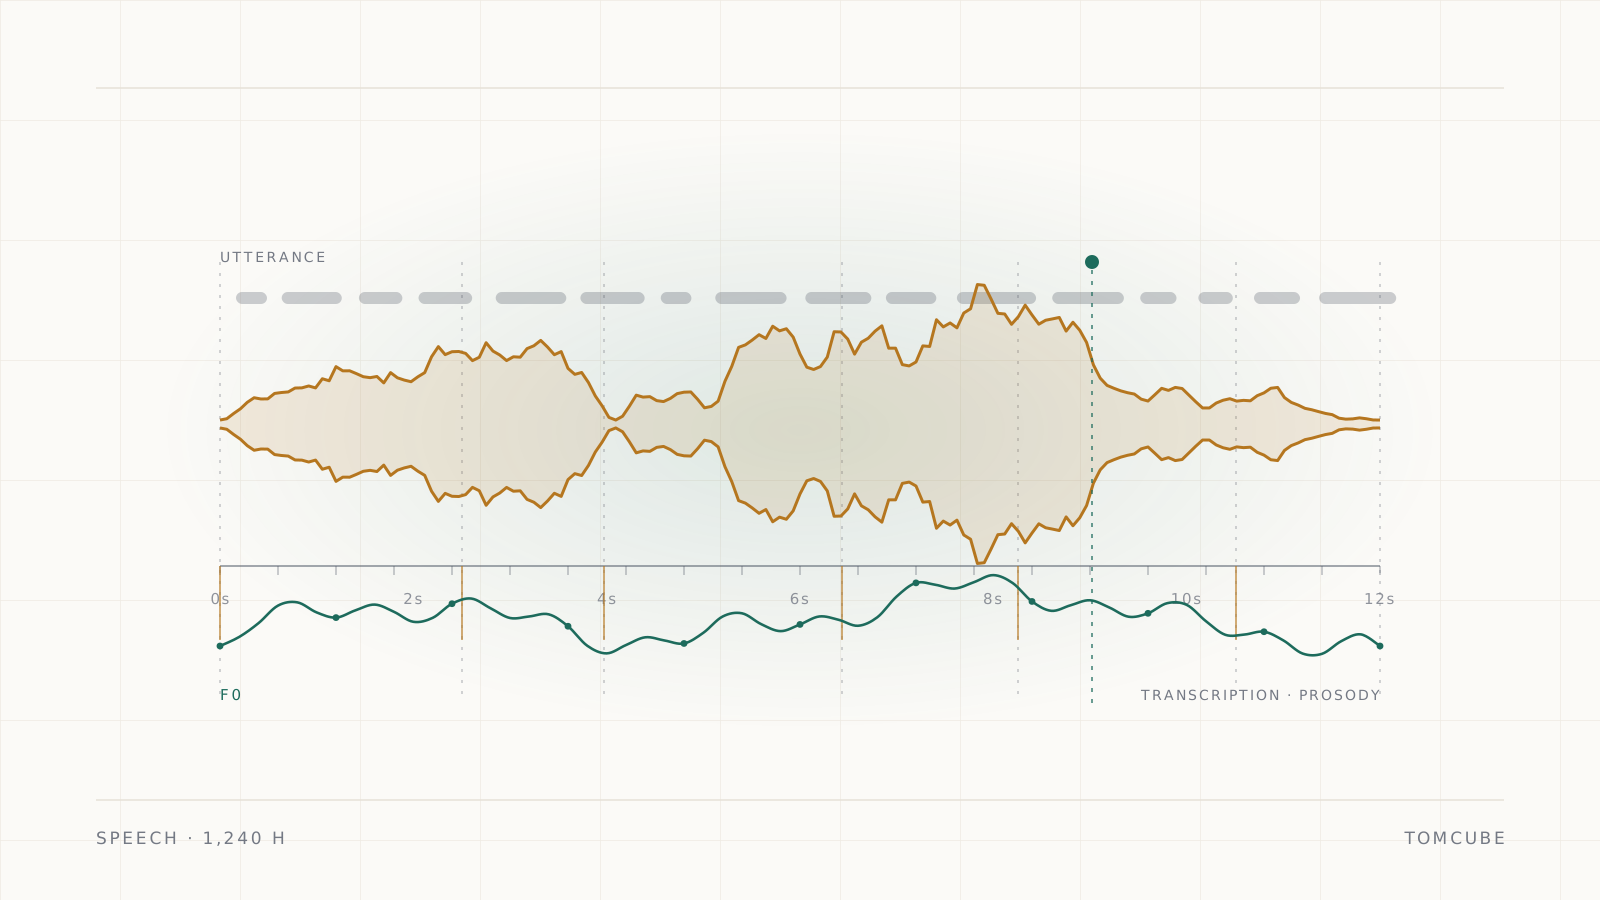
从实验室近讲录音到真实场景远场语音,覆盖朗读、对话与多人交互,提供音素级转写与副语言标注。
视频6 个数据集
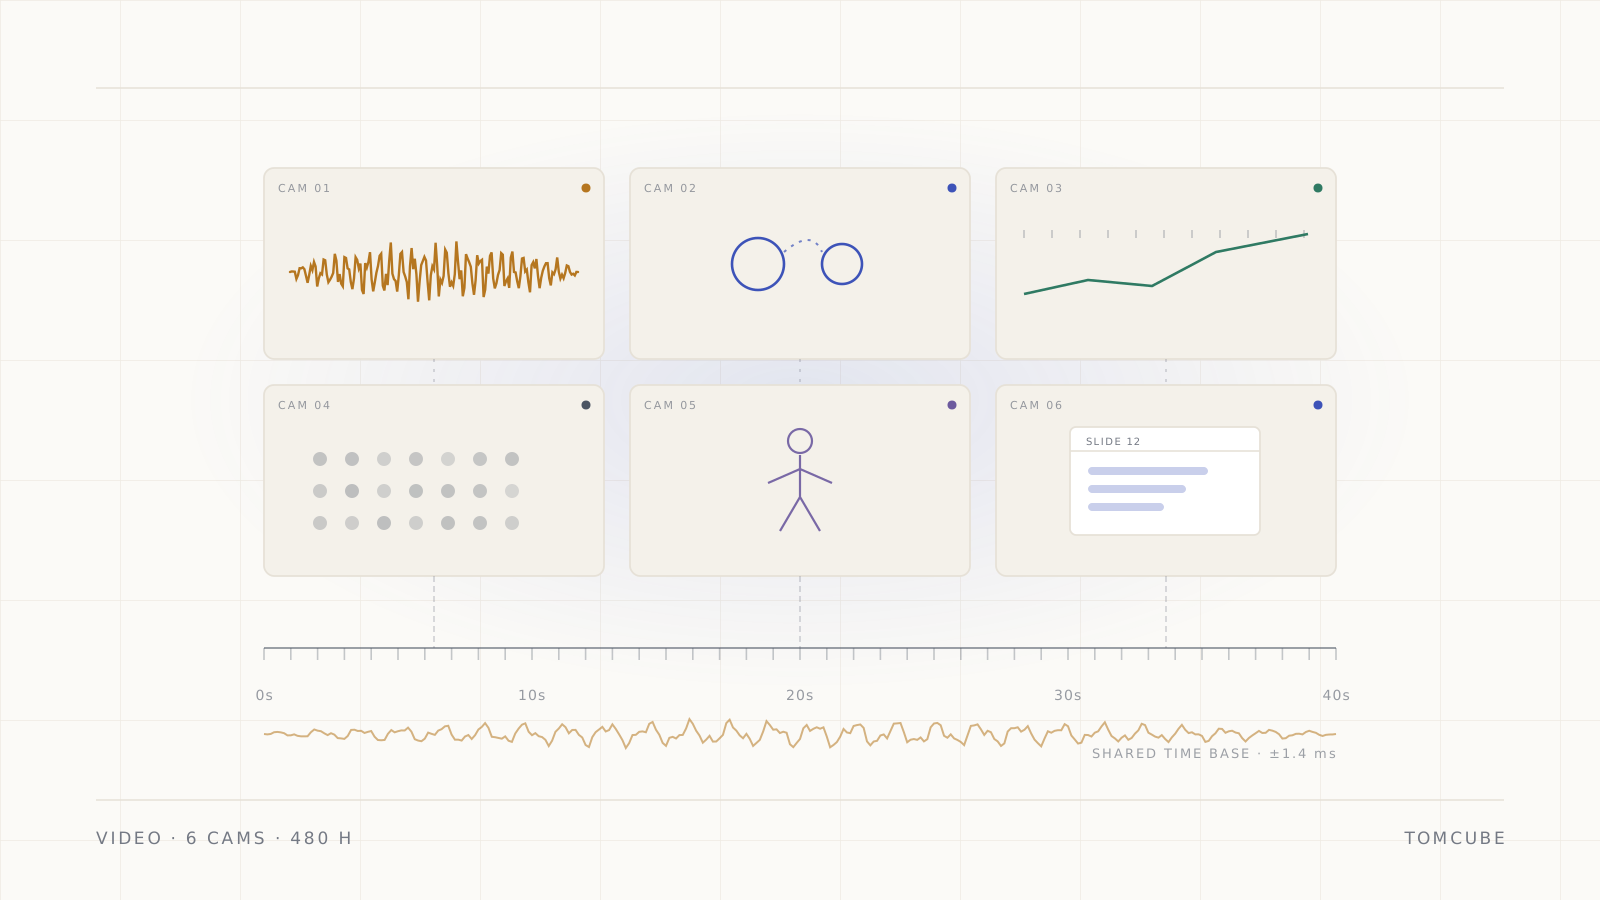
多机位、可穿戴与屏幕录制统一帧率与时基,支持逐帧行为编码、姿态与物体交互标注。
文本8 个数据集
逐字转写、篇章结构与教学话语编码,与音视频精确对齐,可直接用于计算语言学研究。
眼动与视觉1 个数据集
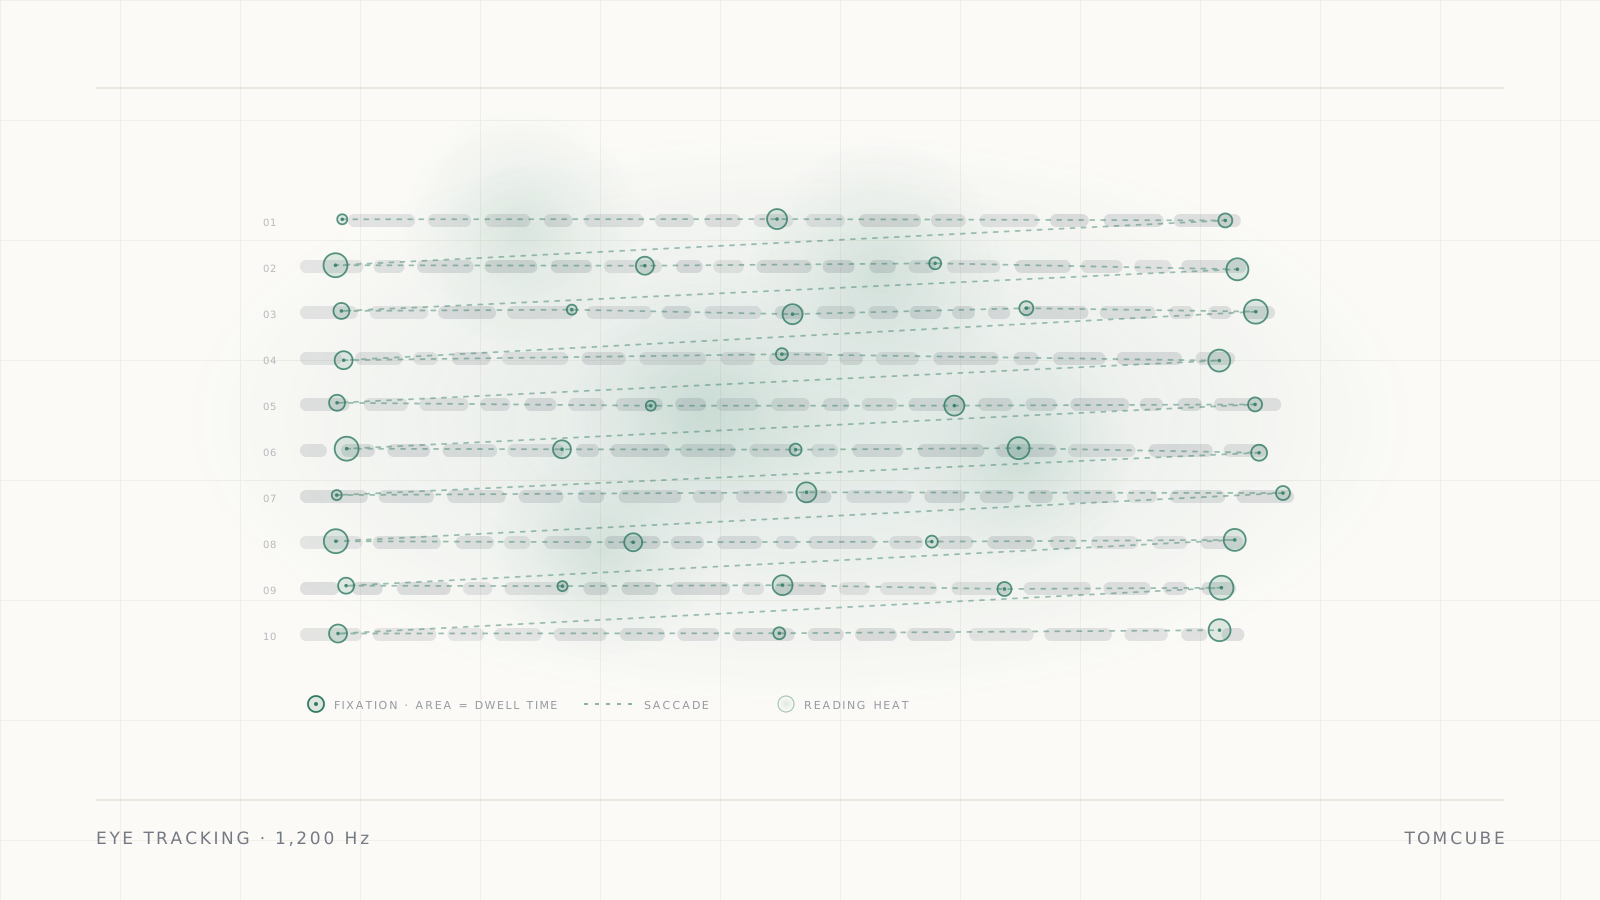
屏幕与场景眼动、注视与回视数据,和刺激材料逐帧对齐,支持阅读、注意与认知负荷分析。
生理信号2 个数据集
脑电、皮电、心率与呼吸等信号带硬件时间戳,落在同一时钟域,可与语言刺激精确对齐。
动作与交互1 个数据集
人体姿态、手势与物体操作轨迹,支持行为分析、具身智能与多模态交互研究。
跨模态融合
把多路数据合成为统一 episode 文件,附带同步清单、标注 schema 与质检报告;可按 RLDS、ELAN、JSON 等格式交付。
02 / How it works
从研究问题到可验证数据
不是把设备架起来录完就结束。每个阶段都有明确的输入、交付物与验收标准,研究团队可以随时查看进度与质控记录。
- 01Design
研究设计
与研究团队共同定义变量、编码手册、统计方案与样本量,先确认数据能回答什么问题。
- 02Collect
采集执行
按场景配置设备与同步方案,完成被试招募、知情同意与现场质控,记录完整采集日志。
- 03Process
处理与标注
转写、强制对齐、切分与多流融合;标注体系经培训与双盲复核,产出结构化元数据。
- 04Validate
验证与交付
同步校验、内容核验、一致性评估与可复现审计全部通过后,才进入交付清单与授权流程。
典型周期:方案确认后 4–6 周交付首批验证数据 · 支持分批交付与中期调整
03 / Datasets
可直接申请的研究级数据
覆盖语言发展、课堂教学、医患沟通、方言保存与人机交互等场景,每一份数据集都附带完整的采集说明与验证报告。
04 / Verification
验证,让数据成为证据
采样结束不等于数据可用。每一批语料都要通过同步校验、内容核验、一致性评估与可复现审计,才会进入交付清单。
同步校验
逐帧比对音频、视频、眼动与生理信号的时基偏移,输出误差分布。
内容核验
按批次抽样复核转写与标注,错误率超过阈值即整批返工。
一致性评估
双盲标注与 κ / α 系数计算,给出可引用的信度指标。
可复现审计
交付采集日志、设备参数、标注手册与版本号,结果可被第三方复核。
- 跨流同步误差(中位)
- 1.4 ms阈值 5 ms
- 标注者一致性
- κ 0.91双盲复核
- 批次抽检比例
- 20%人工复核
- 批次质检通过率
- 98.7%2025 年度
交付物:qc-report.pdf · manifest.json · audit.log · annotation-spec v2.4
05 / Solutions
为两类客户,覆盖六个场景
高校与科研机构关注可发表、可复现;企业与机构关注数据能否直接进入模型与产品。我们用同一套研究级流程服务两种目标。
高校与科研机构
语言学 / 心理学 / 教育学 / 医学
为课题申报、论文发表与数据库建设提供可复现的多模态数据与验证报告,覆盖实验设计、采集、标注与质检全流程。
- 可直接引用的数据描述与方法章节素材
- 伦理审查与数据管理计划支持材料
智能座舱与车载语音
车企 / Tier 1 / 语音供应商
在真实道路与模拟座舱中采集多说话人、强噪声、多音区的语音与行为数据,支撑座舱语音交互与驾驶员状态研究。
- 车内外多音区同步语音语料
- 按环境条件切分的座舱评测集
人机交互与产品研究
产品 / 用户体验 / 研究团队
把语音交互、视线、操作日志与面部表情放在同一时间轴上,为产品决策提供可量化、可复现的行为证据。
- 多模态交互日志与对齐时间轴
- 可用性指标表与按严重程度排序的问题清单
06 / Ecosystem
从高校实验室到产业现场
我们与不同类型的实验室和研究团队共同工作,把采集与验证方法留在真实的研究场景里。
- C9 高校语音实验室语音采集 · 韵律与语音技术
- 语言类高校多模态实验室课堂与访谈 · 多模态标注
- 全景声感知实验室空间音频 · 感知实验数据
- 汽车智能多模态座舱多说话人 · 噪声场景
- 音乐院校多模态实验室演奏动作 · 音频与生理同步
- 语言科学与脑神经EEG / ERP · 语言加工
以及语言科学、认知科学与多模态交互领域的更多合作场景
07 / Research
方法公开,结论可复核
我们把采集规范、标注协议与同步基准公开为可引用的研究成果,也欢迎研究团队在此基础上合作。
- 基准2026 · TOMCUBE Research
MC-Sync:多模态语料同步质量基准
用 12,480 个测量帧评估 6 类采集设备的音视频与传感器同步误差,并给出可复现的评测协议。
- 基准2025 · TOMCUBE Research
方言语音识别鲁棒性基准
在 12 个方言点、3 类噪声条件下评测主流语音识别系统的字错率变化,并给出面向采集端的鲁棒性建议。
- 规范2025 · TOMCUBE Research
课堂多模态标注协议 v2
面向课堂语料的分层标注规范:从话语行为、身势与视线到教学事件,定义标签集、边界规则与双盲复核流程。
Sample pack v2.4
先看数据,再谈合作
40 个 episode、8 路同步数据流、4 个真实采集环境,附完整标注 schema 与质检报告。
- 40
- episode
- 8
- 同步数据流
- 4
- 真实环境
- 2.4 GB
- 数据包
免费申请 · 无需 NDA · 1 个工作日内发送