INSIGHTS / 洞察
儿童语音数据的伦理边界与工程实践
儿童语料的知情同意、声纹可识别性与去标识化难点,以及可以落到流程里的工程措施。
儿童语言发展研究依赖真实、自然、长期的语料。孩子的声音会随年龄快速变化,语境又高度依赖家庭与课堂,因此研究者往往希望采集尽可能连续的样本。但儿童同时是数据保护语境下最需要谨慎对待的群体:他们无法独立完成同意,声音本身具有生物识别属性,语料一旦泄露,影响可能持续到成年。
伦理不是采集流程末端的一张表,而是从研究设计开始就介入的工程约束。这篇文章梳理儿童语音数据的三类风险,以及我们在项目中使用的具体做法。
儿童数据的三个特殊性
第一是同意能力的阶段性。学龄前儿童无法理解「数据会被保存多久、会被谁使用」,但他们的意愿仍然应当被尊重。第二是身份的可识别性。声音携带声纹特征,即使去掉姓名和面孔,一段自然对话仍可能被熟悉的人辨认出来。第三是时间的延展性。儿童语料的价值往往来自纵向追踪,而十年后的使用场景今天无法完全预见。
这三点决定了儿童语料不能套用成人语料的通用流程,必须在同意、去标识化和用途限制上做额外设计。这些风险无法在研究结束后补救,只能在前端解决,因此我们把伦理审查放在方案设计阶段,而不是采集前一周才补材料。
同意不是一张表
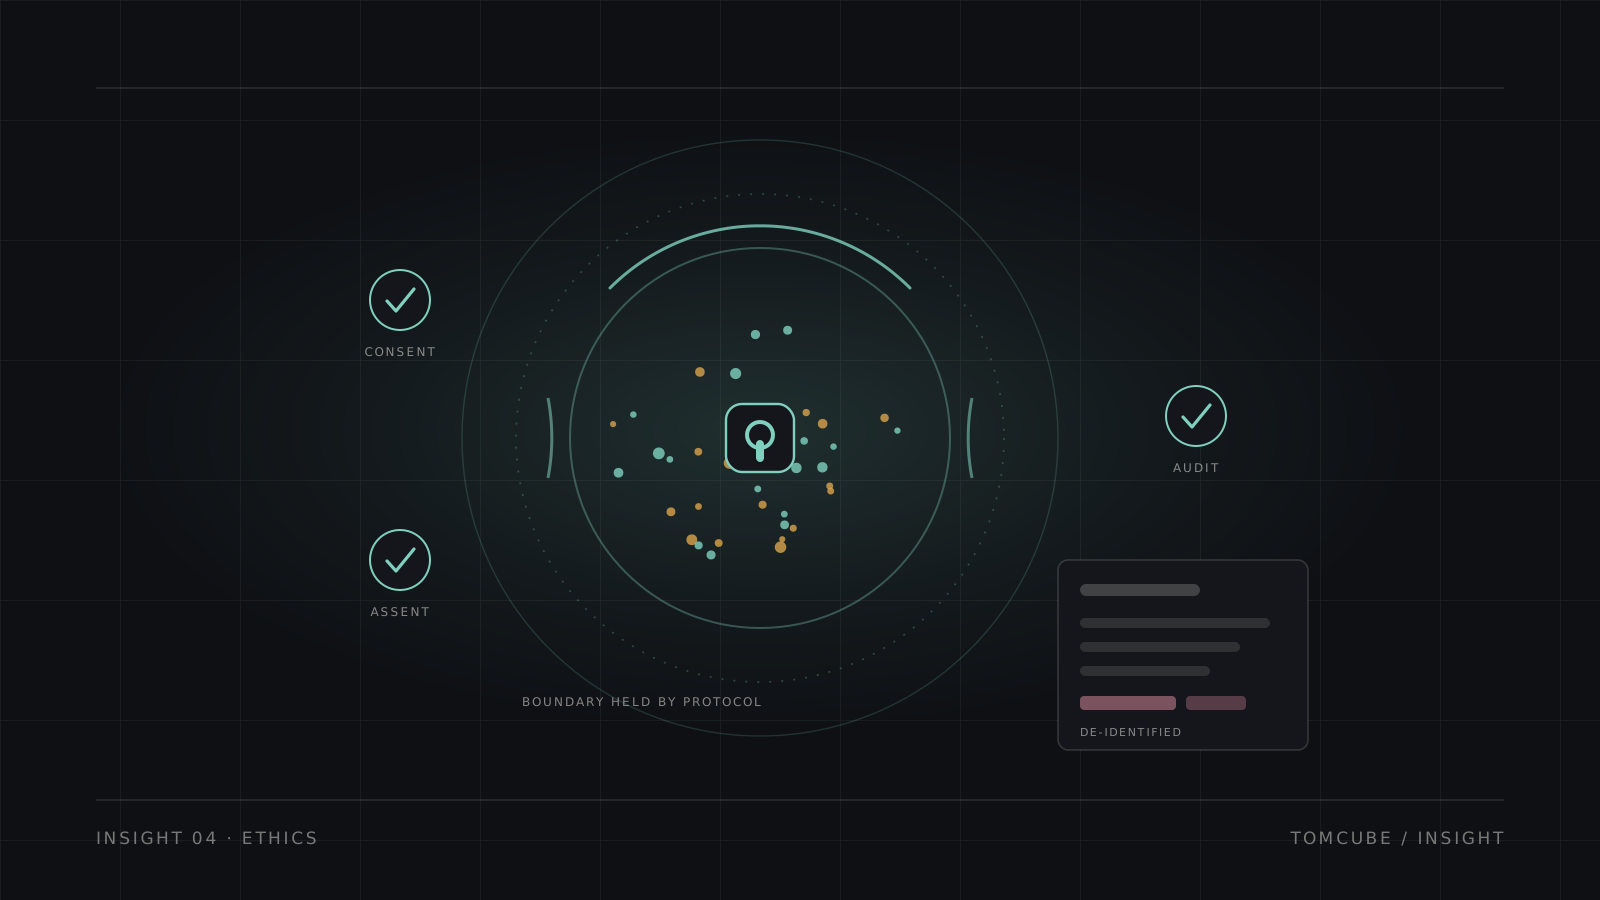
我们把同意拆成三个层次,分别对应不同主体:
- 监护人同意:说明采集内容、保存期限、使用范围、共享方式与撤回渠道,逐项勾选而非一次性打包。
- 儿童本人同意:用适龄语言说明「我们会录下你的声音,用来研究小朋友怎么说话」,并允许孩子在过程中随时停止。
- 机构同意:涉及学校或医院时,同步完成机构层面的伦理审批与数据管理约定。
三层同意都需要留痕:签署时间、说明人、版本号、撤回方式。同意书版本更新后,旧语料的使用范围仍按旧版本执行,不做追溯扩张。
语音的去标识化难在声纹
文本语料去掉姓名与地点即可大幅降低识别风险,语音不行。声纹是生物特征,简单的变调或加噪会破坏研究价值,又不能可靠地消除可识别性。我们的处理策略是分层:
- 保留原始音频,但仅限受控环境访问,访问记录可审计。
- 交付分析用副本,做音高与语速归一化、去除环境中的可识别信息(如家庭成员的姓名、住址)。
- 对高风险片段,例如含明确身份信息的自述,做内容裁剪或仅提供转写与特征文件。
同时,我们把「可识别性评估」写进质检清单:由未参与采集的成员试听交付副本,判断是否能猜出说话人身份,作为放行条件之一。
工程实践清单
伦理要求只有落进流程才不会流于形式。下表是我们使用的关键控制点。
| 阶段 | 措施 | 留痕 |
|---|---|---|
| 研究设计 | 最小化采集范围,明确用途与期限 | 数据管理计划 |
| 招募 | 分层同意书、适龄说明材料 | 同意书编号与版本 |
| 采集 | 允许随时暂停,避免长时间连续录制 | 采集日志、暂停记录 |
| 处理 | 声纹风险评估、内容裁剪 | 去标识化记录 |
| 存储 | 加密存储、分级权限、访问日志 | 访问审计记录 |
| 共享 | 按用途授权,禁止再识别尝试 | 授权协议 |
| 销毁 | 到期删除并出具销毁证明 | 销毁记录 |
审查流程与红线
项目启动前,伦理审查会检查四件事:同意流程是否覆盖三层主体,采集范围是否真的最小化,去标识化方案是否经过试听验证,以及共享与销毁是否有明确责任人。任何一项不通过,项目不进入采集。
同时我们设定几条不妥协的红线:不采集与语言研究无关的家庭隐私内容;不把儿童语料用于未在同意书中列明的商业用途;不允许以「研究需要」为由跳过监护人同意;不在公开渠道发布可识别的儿童音视频片段。
结语
儿童语料的伦理边界不是研究效率的对立面。把同意做细、把去标识化做实、把用途写清,反而能让研究者和被研究者都更安心地推进长期追踪。对汤川科技来说,这部分工作不会体现在数据规模上,但它决定了这些语料能否被负责任地使用十年。