INSIGHTS / 洞察
标注一致性:κ = 0.8 什么时候还不够
κ = 0.91 的中位数背后,一致性系数在哪些情形下会失真,以及如何用分层报告替代单一数字。
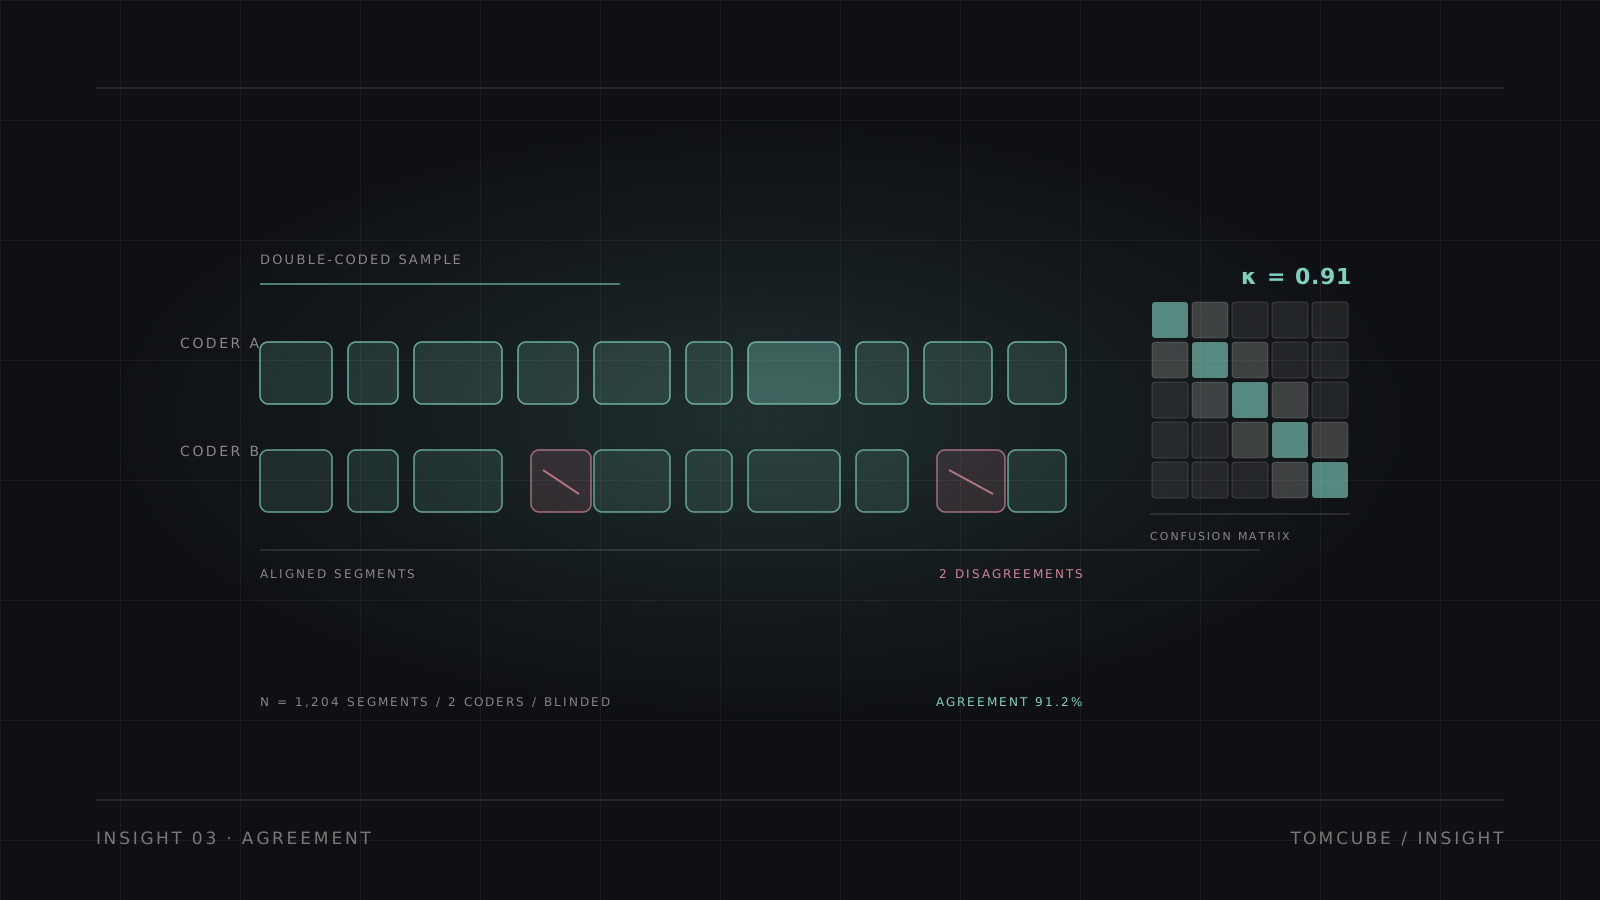
在标注项目的验收表里,Cohen’s κ 常常是唯一被提及的一致性指标。κ = 0.8 被当作「可以交付」的门槛,低于它就返工,高于它就放行。但 κ 只是一个相关系数,它既可能被高估,也可能在真正需要警惕的时候显得体面。汤川科技 2025 年度交付批次的标注一致性中位数为 κ = 0.91,但我们在报告里从不只写这一个数字。
κ 在测量什么
κ 衡量的是标注者之间的一致性,并扣除了随机猜测带来的偶然一致。它的分母是「在随机标注下还能提高的空间」,因此当某一类标签在样本中占比极高时,κ 的波动会变得很不稳定。举一个极端例子:如果 95% 的样本都是「没有重叠发言」,两位标注者都倾向于标「没有重叠」,他们的一致率可以很高,但 κ 可能并不高;反过来,如果某类样本极少,一次分歧就会让 κ 剧烈下降。
这意味着 κ 既不能单独用来判断标注质量,也不能跨任务直接比较。语音转写的字准确率、副语言标签、对话行为分类,它们的标签空间和边界清晰度完全不同,同一套阈值并不成立。
三种让 κ 失真的情形
我们在复核中反复遇到三类情况,它们会让 κ 偏离真实质量:
- 类别极度不平衡:多数类占据 90% 以上样本,κ 受少数类分歧支配,方差很大。
- 边界定义模糊:标注手册没有给出可判定的边界案例,标注者各自形成隐性标准,κ 看起来尚可,但错误集中在同一批样本上。
- 标注者同源:两位标注者接受同一套培训、使用同一份示例,分歧被系统性抹平,κ 偏高但不代表可复现。
第一类问题需要改用 Gwet’s AC1 或按类别分层报告;第二类问题必须回到手册,补充边界案例与裁决记录;第三类问题则要求引入独立标注者或第三方抽检。
还有一类更隐蔽的情形:标注任务本身没有唯一答案。比如「这句话是否带有讽刺意味」,不同标注者的判断都能自洽。这时任务的目标不是追求高 κ,而是记录判断依据,并在报告中说明标签的解释边界。
不同任务的一致性参考区间
阈值应当按任务设定,而不是全站统一。下表是我们内部使用的参考区间,数值来自历年交付批次的统计,仅作起点,具体项目仍要以预标注结果校准。
| 任务类型 | 主要指标 | 参考区间 | 说明 |
|---|---|---|---|
| 逐字转写 | 字符错误率 | ≤ 3% | 与参考转写对比 |
| 音素级标注 | κ | 0.85 – 0.95 | 边界音素需单独抽检 |
| 对话行为分类 | κ | 0.75 – 0.90 | 类别多、边界模糊 |
| 情感与副语言 | 加权 κ | 0.70 – 0.85 | 有序标签用加权 κ |
| 事件边界检测 | 时间容差内一致率 | ≥ 90% | 容许 ±50 ms |
区间存在的意义是让团队在开工前就知道目标在哪里,而不是等验收时才发现「0.8 算高还是算低」。
比 κ 更有用的三件事
一致性报告如果只写一个数字,它就很难指导改进。我们更看重三样东西:
- 分层一致性:按类别、说话人、场景分别报告,找出分歧集中的子集。
- 边界样本清单:把所有出现分歧的样本挑出来,形成下一版手册的修订依据。
- 裁决记录:第三方裁决的每一条决定都要写下理由,形成可追溯的标准演化史。
这三样东西加起来,才构成一份能解释「为什么一致、为什么不一致」的报告。
一条可操作的一致性流程
我们通常按下面的顺序推进,每一步都有明确的产出:
- 预标注:两名标注者独立标注 100 条样本,计算初始一致性,暴露手册缺口。
- 手册修订:针对分歧样本补充边界定义,更新示例库。
- 全量双盲标注:两份标注互不可见,避免相互影响。
- 分歧裁决:由第三方逐条裁决并记录理由,统计裁决率。
- 抽检复核:对高分歧类别追加 10% 抽检,确认修订有效。
- 交付报告:给出分层一致性、边界清单与裁决记录,而非单一 κ。
结语
κ = 0.8 不是一条普适的安全线,它只在特定任务、特定类别分布下才有意义。把一致性当作一个需要被解释的现象,而不是一个需要被凑到的数字,标注质量才真正可控。对使用语料的研究者来说,一份写清了边界与分歧的报告,比一个漂亮的 κ 更有价值。
RELATED / 相关阅读
继续阅读
同一主题下的方法与实践记录。