01 / 数据构成
规模、关键指标与数据流
把情绪从单一模态还原为多通道证据
- 380 h
- 总时长
- 1,200 名
- 参与者
- 7 类
- 情绪类别
- 4 路
- 生理通道
| 数据流 | 规格 | 说明 |
|---|---|---|
| 音频 | 48 kHz / 24-bit | 头戴麦克风,保留呼吸与停顿 |
| 视频 | 1920 × 1080 · 60 fps | 正面机位,覆盖面部与上半身 |
| 生理 | 1,000 Hz | 皮电、心率、呼吸与肌电四路 |
| 文本 | UTF-8 / JSON | 诱发材料、自评量表与转写 |
表格为示例批次的采集参数,最终规格以随数据交付的说明文档为准。
02 / 数据说明
采集、标注与质量控制
以下内容说明数据如何被采集、标注与验证,可作为方法学引用与方案评估的依据。
数据概况
多模态情感与副语言语料库包含 1,200 名参与者,累计 380 小时,采集时间为 2024 年 6 月至 2026 年 6 月。语料通过情境诱发与自然表达两种方式获得,覆盖高兴、悲伤、愤怒、恐惧、惊讶、厌恶与中性 7 类情绪,每类情绪在积极、中性、消极语境下均有分布。
参与者按性别、年龄与职业背景分层,其中 240 人完成两轮采集,用于评估个体情绪表达的时间稳定性。副语言风格变量包括语速、音量、音高范围与停顿密度。
采集规范
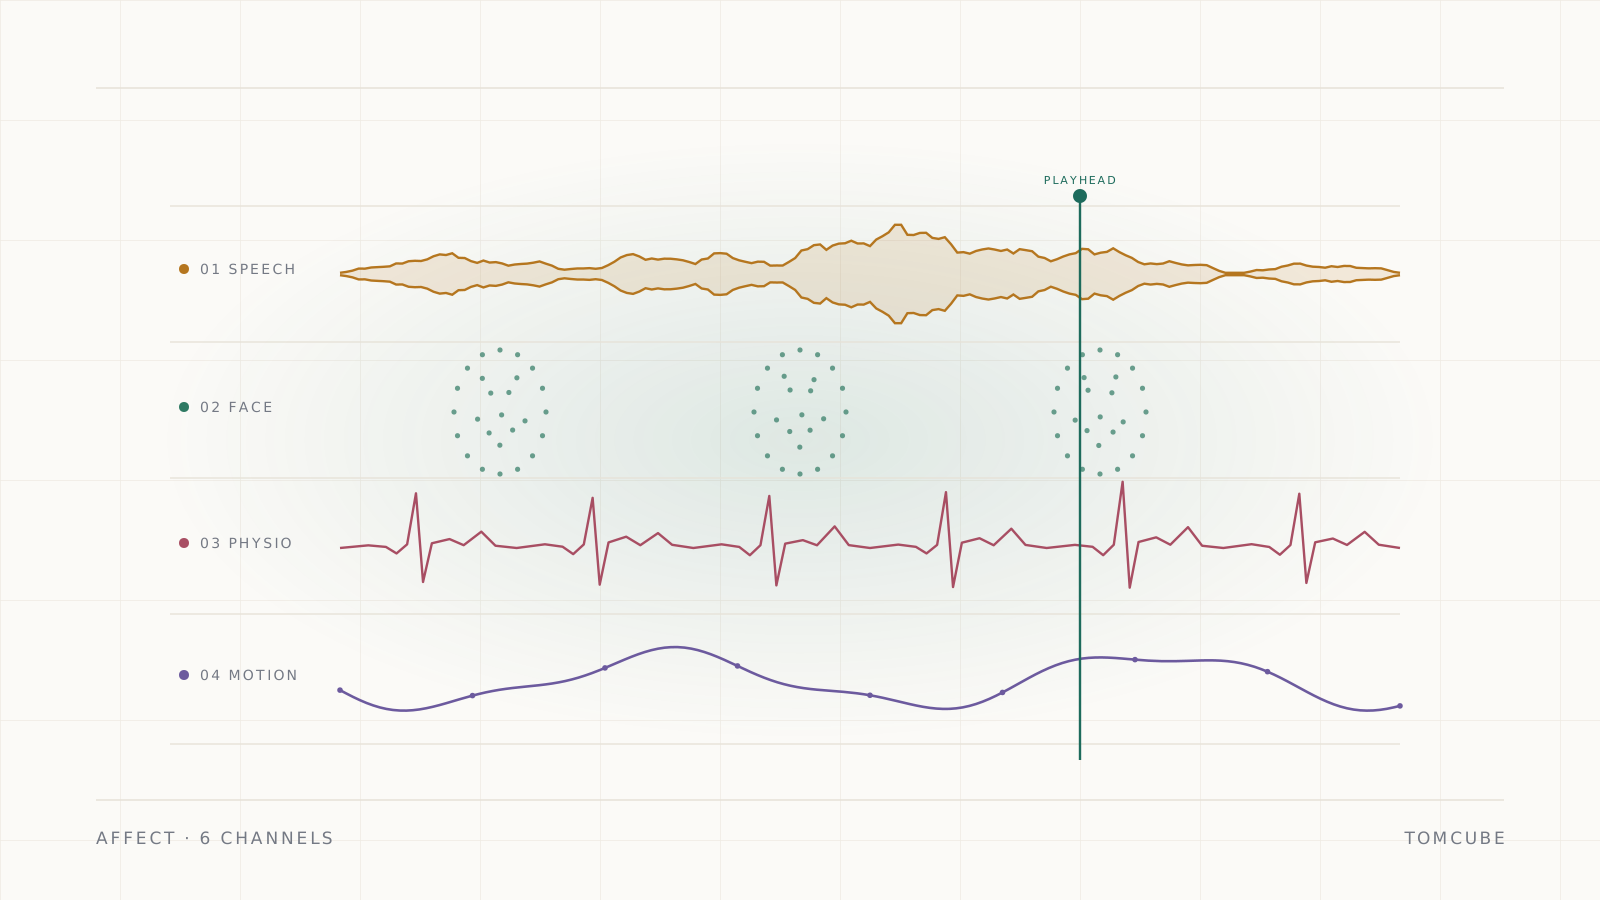
采集在声学处理过的实验室内完成,音频 48 kHz / 24-bit,视频 1920 × 1080 · 60 fps 正面机位,生理通道以 1,000 Hz 记录皮电、心率、呼吸与面部肌电。所有通道接入同一采集主机,由触发盒统一打点标记,保证跨通道时间对齐。
情绪诱发采用经过预测试的标准化材料,包括短视频、图片与角色扮演任务。参与者在每个试次后完成效价与唤醒度的九点量表自评。采集全程遵守伦理规范,参与者可随时退出;涉及个人经历的叙述内容在入库前做内容审查与脱敏。
标注体系
标注结合主观自评、专家编码与自动特征三层证据。
| 层级 | 内容 | 规模 | 复核方式 |
|---|---|---|---|
| 自评层 | 效价、唤醒度、支配感 | 全量试次 | 量表质量控制 |
| 专家层 | 情绪类别、强度、混合情绪 | 约 4.2 万片段 | 双人标注,仲裁复核 |
| 面部层 | 动作单元(AU)与强度 | 全量视频 | 自动检测 + 抽检 15% |
| 副语言层 | 语速、音高、能量、停顿 | 全量音频 | 算法提取 + 抽检复核 |
质量与验证
音视频与生理信号同步误差中位数 1.1 ms,95 分位不超过 2 ms;专家情绪标注一致性 κ = 0.83;面部动作单元检测与人工编码一致率 91.7%;生理信号伪迹比例低于 4%。每批次抽取 12% 片段做双盲复核,情绪诱发失败(自评与预期类别不符)的试次单独标记。交付附诱发材料清单、量表编码、特征提取脚本与同步报告。
典型研究问题
- 单一模态与多模态融合在情绪识别上的性能差距。
- 情绪强度与音高范围、语速之间的非线性关系。
- 生理唤醒度对语音情绪表达的预测力。
- 跨被试、跨性别情绪识别模型的泛化边界。
- 混合情绪在多通道上的不一致表现。
获取与授权
科研授权面向情感计算、语言学与心理学团队,商业授权面向人机交互、智能座舱与心理健康产品。交付格式为 WAV、MP4、CSV 与 JSON,特征表与原始信号分开提供。因涉及生理与面部数据,申请方需提供伦理审查证明与数据安全方案。可先通过示例数据查看片段级字段,或在联系页讨论授权范围。
03 / 典型用途
这批数据可以回答的问题
以下为典型研究与产品方向,具体分析方案需结合研究设计与统计方法确定。
- 01
多模态情绪识别基准
- 02
情绪与声学特征关联
- 03
跨被试情绪泛化评估
- 04
人机交互共情设计
04 / 相关数据集
可以组合使用的数据集
同一研究问题常需要跨模态组合;以下条目与本数据集共享场景、说话人或标注体系。