01 / 数据构成
规模、关键指标与数据流
在真实问诊场景中记录语言、表情与互动
- 620 h
- 总时长
- 1,450 次
- 问诊
- 6 个
- 科室
| 数据流 | 规格 | 说明 |
|---|---|---|
| 音频 | 48 kHz / 24-bit · 双通道 | 医生与患者独立通道,保留自然重叠 |
| 视频 | 1920 × 1080 · 30 fps | 双机位,覆盖双方上半身 |
| 文本 | UTF-8 / JSON | 去标识化逐字转写与说话人分离 |
表格为示例批次的采集参数,最终规格以随数据交付的说明文档为准。
02 / 数据说明
采集、标注与质量控制
以下内容说明数据如何被采集、标注与验证,可作为方法学引用与方案评估的依据。
数据概况
医患问诊多模态语料库包含 1,450 次真实门诊问诊,累计 620 小时,覆盖内科、外科、儿科、皮肤科、心理科与康复科 6 个科室,采集时间为 2024 年 1 月至 2026 年 4 月。单次问诊平均时长 25.7 分钟,最短 6 分钟,最长 58 分钟,保留从患者入座到离开的完整过程。
语料按科室、问诊类型(初诊、复诊、随访)与医生年资分层,同一医生贡献 10 至 30 次问诊,用于比较个体沟通风格与稳定模式。
采集规范
诊室内布置双通道领夹麦克风,医生与患者各自独立通道、48 kHz / 24-bit 录制;视频采用两台 1920 × 1080 · 30 fps 机位,分别记录双方上半身与手部动作。采集前由医院伦理委员会审批,患者与医生分别签署知情同意书,允许在任何环节无条件退出。
为控制隐私风险,诊室内的病历屏幕、检验单与身份信息在采集端即做遮挡;转写阶段执行严格的去标识化流程,人名、地名、机构名、日期与编号统一替换为类型化占位符,替换映射表不随数据交付。
标注体系
标注由具备医学背景的标注员完成,医学实体部分由临床医生复核。
| 层级 | 内容 | 规模 | 复核方式 |
|---|---|---|---|
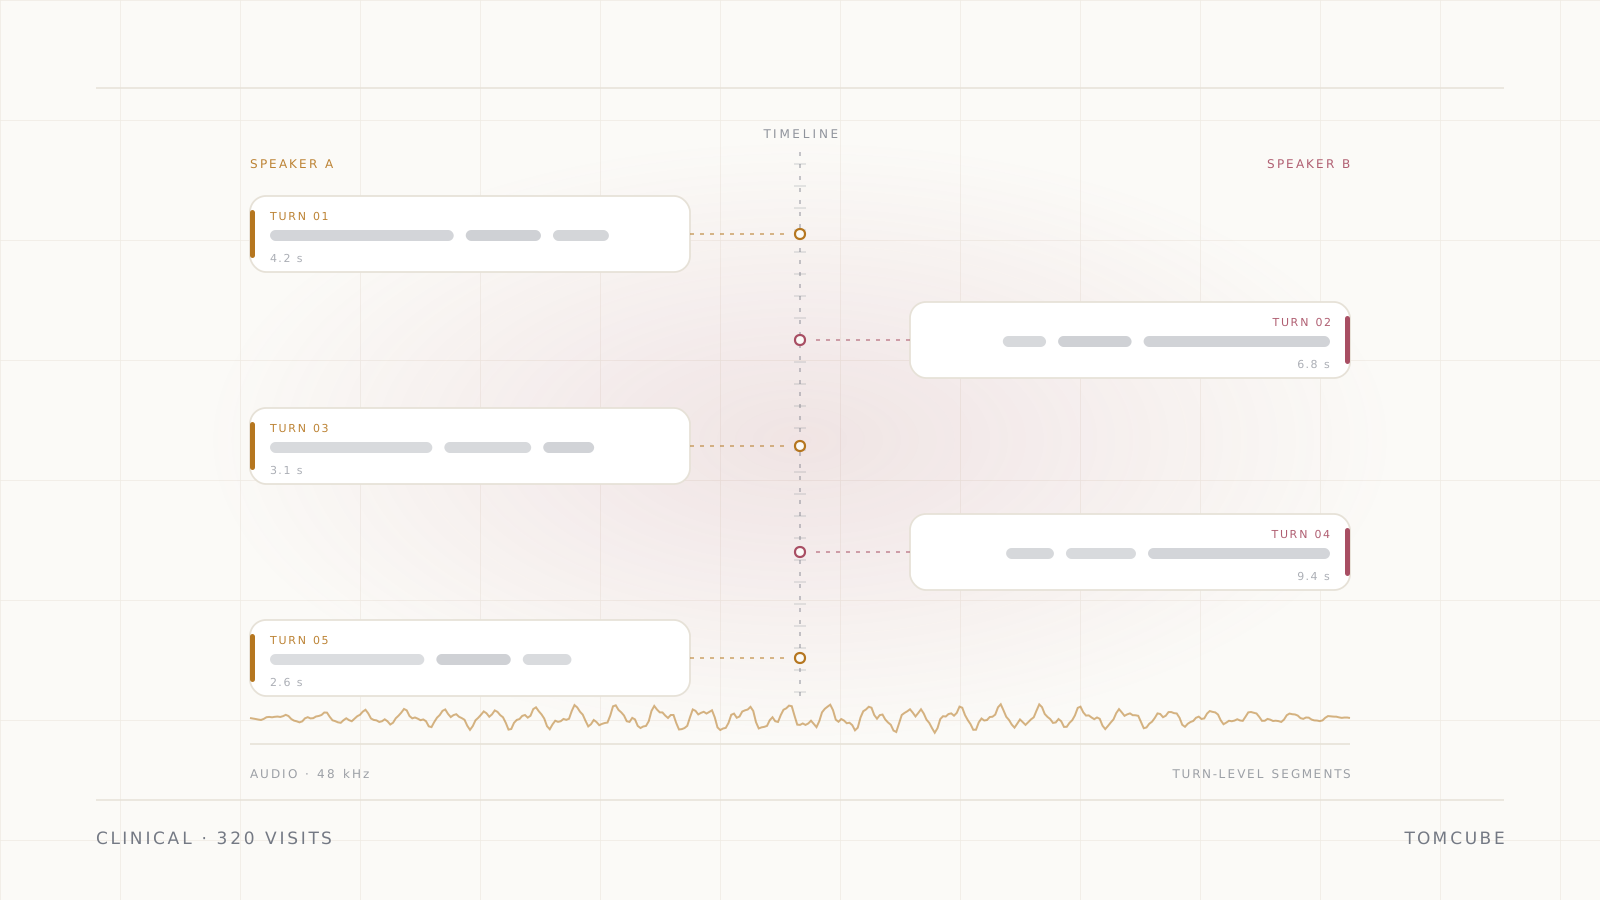
| 会话层 | 话轮切分、话题转换、打断与重叠 | 约 38 万话轮 | 双盲复核 20% |
| 沟通层 | 共情、安抚、解释、共同决策 | 12 类沟通行为 | 双人标注,κ 报告 |
| 实体层 | 症状、检查、诊断、用药、剂量 | 约 21 万实体 | 医生抽检 15% |
| 非言语层 | 点头、皱眉、手势、目光 | 8 类行为 | 关键片段双人标注 |
质量与验证
音视频同步误差中位数 1.2 ms,95 分位不超过 2 ms;转写字准确率 98.9%;沟通行为标注一致性 κ = 0.88;医学实体 F1 为 0.94。每批次抽取 10% 问诊做双盲复核,去标识化结果由独立小组二次扫描,漏检率低于 0.1%。交付附伦理审批文件摘要、去标识化说明与标注一致性报告。
典型研究问题
- 医生共情表达与患者后续依从性的关联。
- 不同科室问诊结构的差异与信息传递效率。
- 患者犹豫、回避等非言语信号的出现规律。
- 临床对话摘要模型在真实问诊上的事实一致性。
- 方言口音对医患理解与重复解释的影响。
获取与授权
本数据集仅面向通过伦理审查的研究项目与合规商业场景开放。科研授权需提交研究方案、伦理批件与数据管理计划;商业授权另需签署数据处理协议,禁止再识别与原始影像二次传播。交付格式为 WAV、MP4、TextGrid 与 JSON,可按科室与问诊类型筛选。可先通过示例数据查看脱敏字段结构,或在联系页预约伦理与授权沟通。
03 / 典型用途
这批数据可以回答的问题
以下为典型研究与产品方向,具体分析方案需结合研究设计与统计方法确定。
- 01
医患沟通质量评估
- 02
共情语言与患者满意度研究
- 03
临床对话摘要与实体抽取
- 04
问诊流程与沟通培训
04 / 相关数据集
可以组合使用的数据集
同一研究问题常需要跨模态组合;以下条目与本数据集共享场景、说话人或标注体系。