01 / 数据构成
规模、关键指标与数据流
在真实设备与真实环境中观察人与语音助手的对话
- 760 h
- 总时长
- 3,200 名
- 用户
- 5 类
- 场景
- 约 42 万条
- 指令
| 数据流 | 规格 | 说明 |
|---|---|---|
| 音频 | 16 kHz / 24-bit · 近远场 | 设备麦克风与参考阵列双路 |
| 文本 | JSONL / UTF-8 | ASR 输出、人工转写与交互日志 |
| 日志 | JSONL | 唤醒、响应、打断与重试事件 |
| 视频 | 1280 × 720 · 30 fps | 可选场景视频,记录交互姿态 |
表格为示例批次的采集参数,最终规格以随数据交付的说明文档为准。
02 / 数据说明
采集、标注与质量控制
以下内容说明数据如何被采集、标注与验证,可作为方法学引用与方案评估的依据。
数据概况
人机语音交互真实场景语料库记录 3,200 名用户与语音助手在 5 类真实场景中的交互,累计 760 小时、约 42 万条指令,采集时间为 2024 年 8 月至 2026 年 5 月。场景包括家庭客厅、车内、办公室、公共空间与户外,覆盖安静、中等噪声与强噪声三种声学条件。
语料按设备形态(智能音箱、车载语音、手机助手、耳机与可穿戴)与口音类型分层,其中 6 种常见地方口音单独标注。每位用户完成 20 至 45 分钟的自由使用与任务清单,任务清单覆盖查询、控制、闲聊与多轮订正四类交互。
采集规范
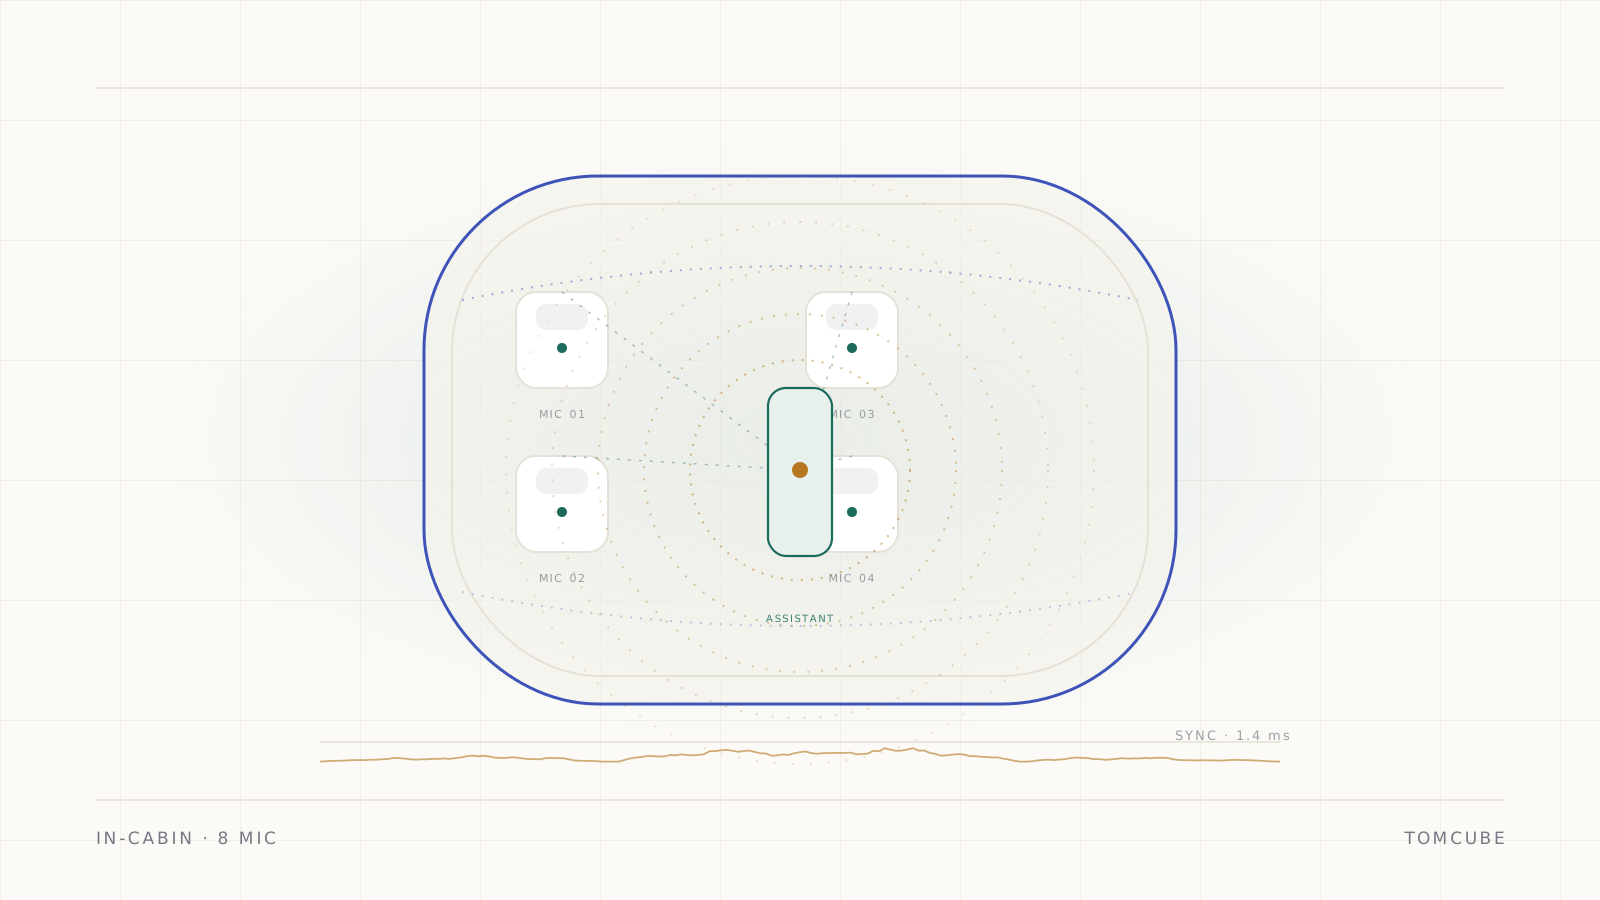
音频采用双路记录:设备自身麦克风与部署在场景中的参考阵列,前者反映真实识别条件,后者用于声学分析与对齐;采样率 16 kHz / 24-bit。交互日志从设备端导出,记录唤醒词命中、响应延迟、打断与重试事件,日志时间戳与音频通过设备时钟校正后对齐。
采集在用户知情同意的前提下进行,不录制无关人员可识别对话;视频仅在用户单独授权时记录,且只保留交互相关片段。家庭场景由研究助理上门完成设备部署,公共空间与车内场景遵循相应的场所许可流程。
标注体系
标注围绕「用户说了什么、系统理解成什么、如何纠正」三个问题展开。
| 层级 | 内容 | 规模 | 复核方式 |
|---|---|---|---|
| 转写层 | 唤醒词、指令、环境语音、重叠语音 | 约 42 万条指令 | 双盲复核 20% |
| 语义层 | 意图、槽位、指代与省略 | 38 类意图、64 类槽位 | 双人标注,仲裁复核 |
| 对话层 | 对话状态、系统确认、用户修正 | 全量多轮会话 | 规则校验 + 抽检 15% |
| 行为层 | 重试、放弃、切换模态、提高音量 | 6 类行为 | 日志与音频交叉验证 |
质量与验证
设备日志与音频同步误差中位数 1.1 ms,95 分位不超过 2 ms;人工转写字准确率 98.4%;意图标注一致性 κ = 0.89;槽位标注 F1 为 0.92。每批次抽取 12% 会话做双盲复核,强噪声条件下的低信噪比片段单独标记。交付附设备配置说明、声学条件分级、意图槽位体系与错误分析报告。
典型研究问题
- 不同噪声条件下唤醒词误触发与漏触发的差异。
- 地方口音对意图识别准确率的影响。
- 用户在多轮失败后的修正策略与放弃阈值。
- 车载与家庭场景的交互时长与打断模式比较。
- 语音与屏幕、手势等模态的协同使用规律。
获取与授权
商业授权面向语音技术、智能终端与车载语音团队,科研授权面向人机交互与语音研究实验室。交付格式为 WAV、JSONL、CSV 与 TextGrid,可按设备形态、场景与口音筛选;设备端原始日志与人工标注分层交付。申请方需说明使用目的并签署数据处理协议。可先通过示例数据查看会话级字段结构,或在联系页预约评测方案沟通。
03 / 典型用途
这批数据可以回答的问题
以下为典型研究与产品方向,具体分析方案需结合研究设计与统计方法确定。
- 01
远场语音识别评测
- 02
对话系统意图理解
- 03
唤醒词误触发分析
- 04
多轮交互错误恢复研究
04 / 相关数据集
可以组合使用的数据集
同一研究问题常需要跨模态组合;以下条目与本数据集共享场景、说话人或标注体系。